

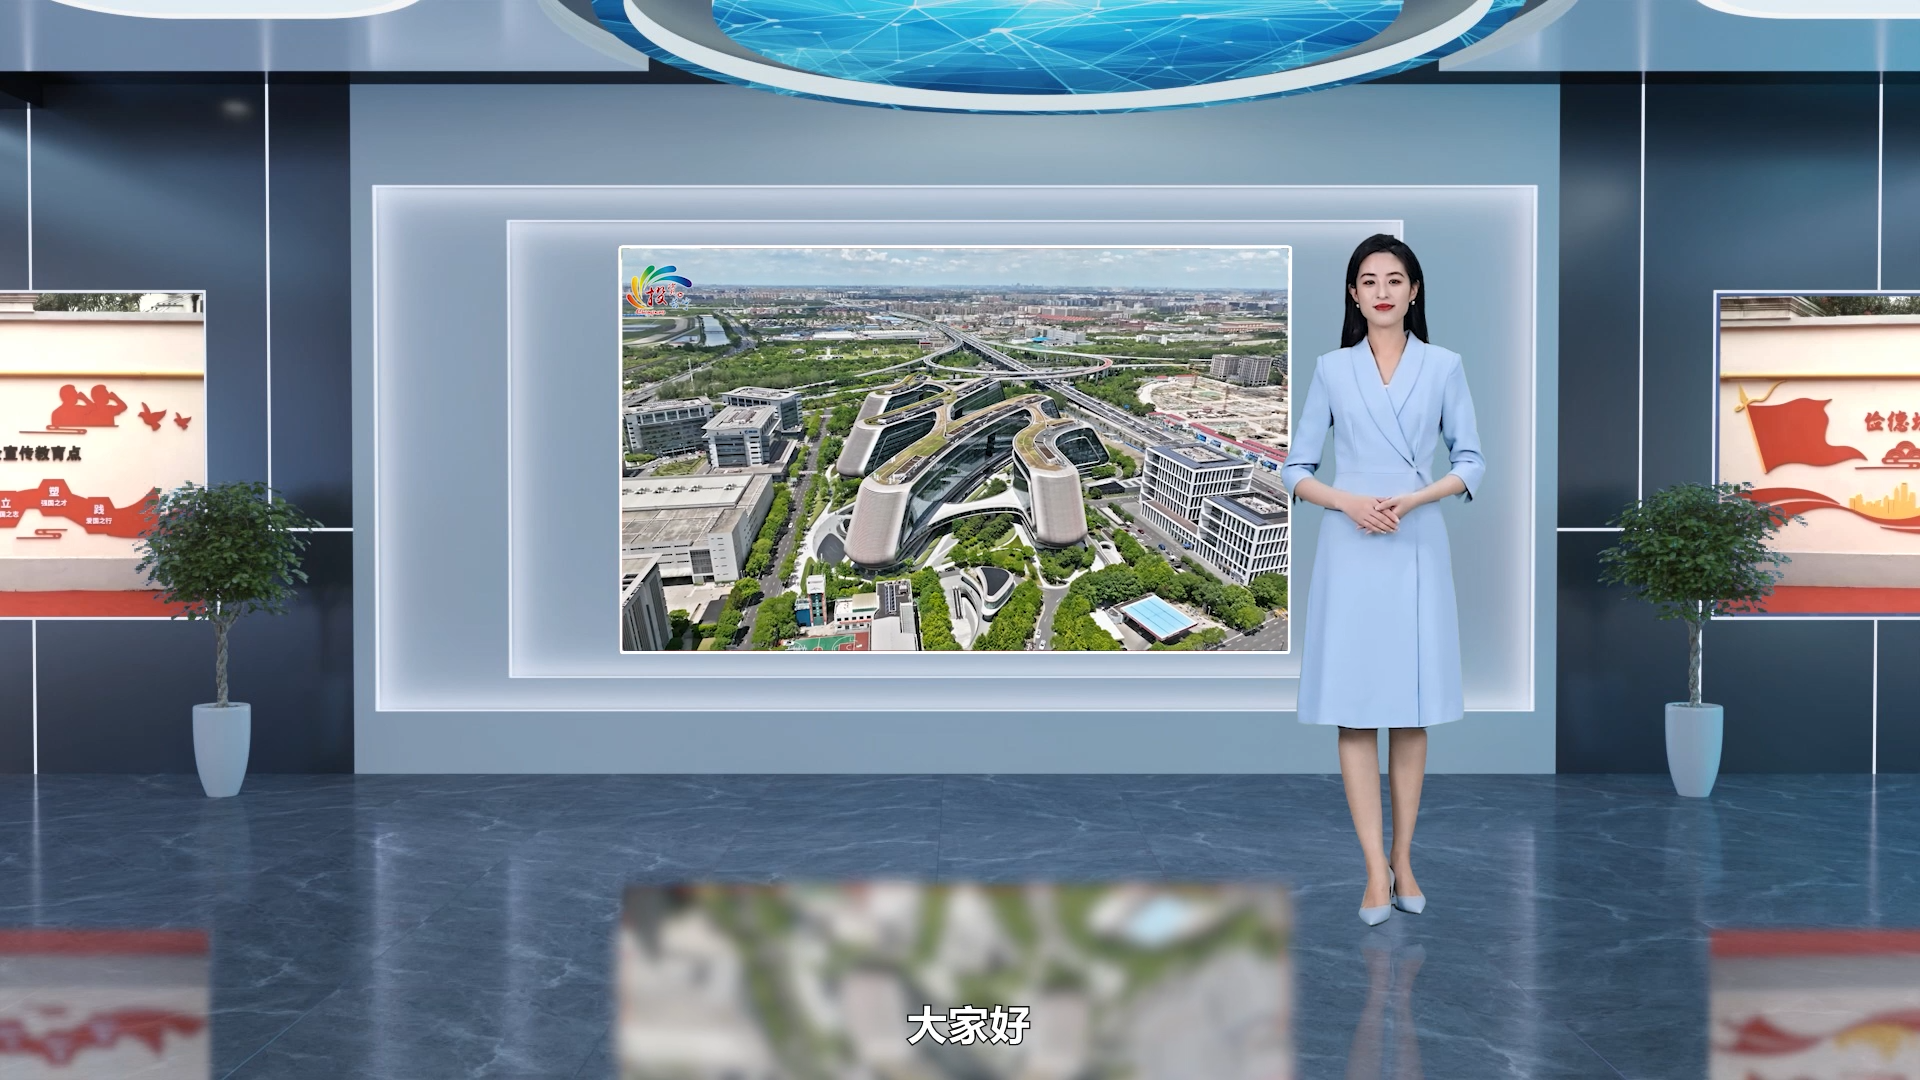
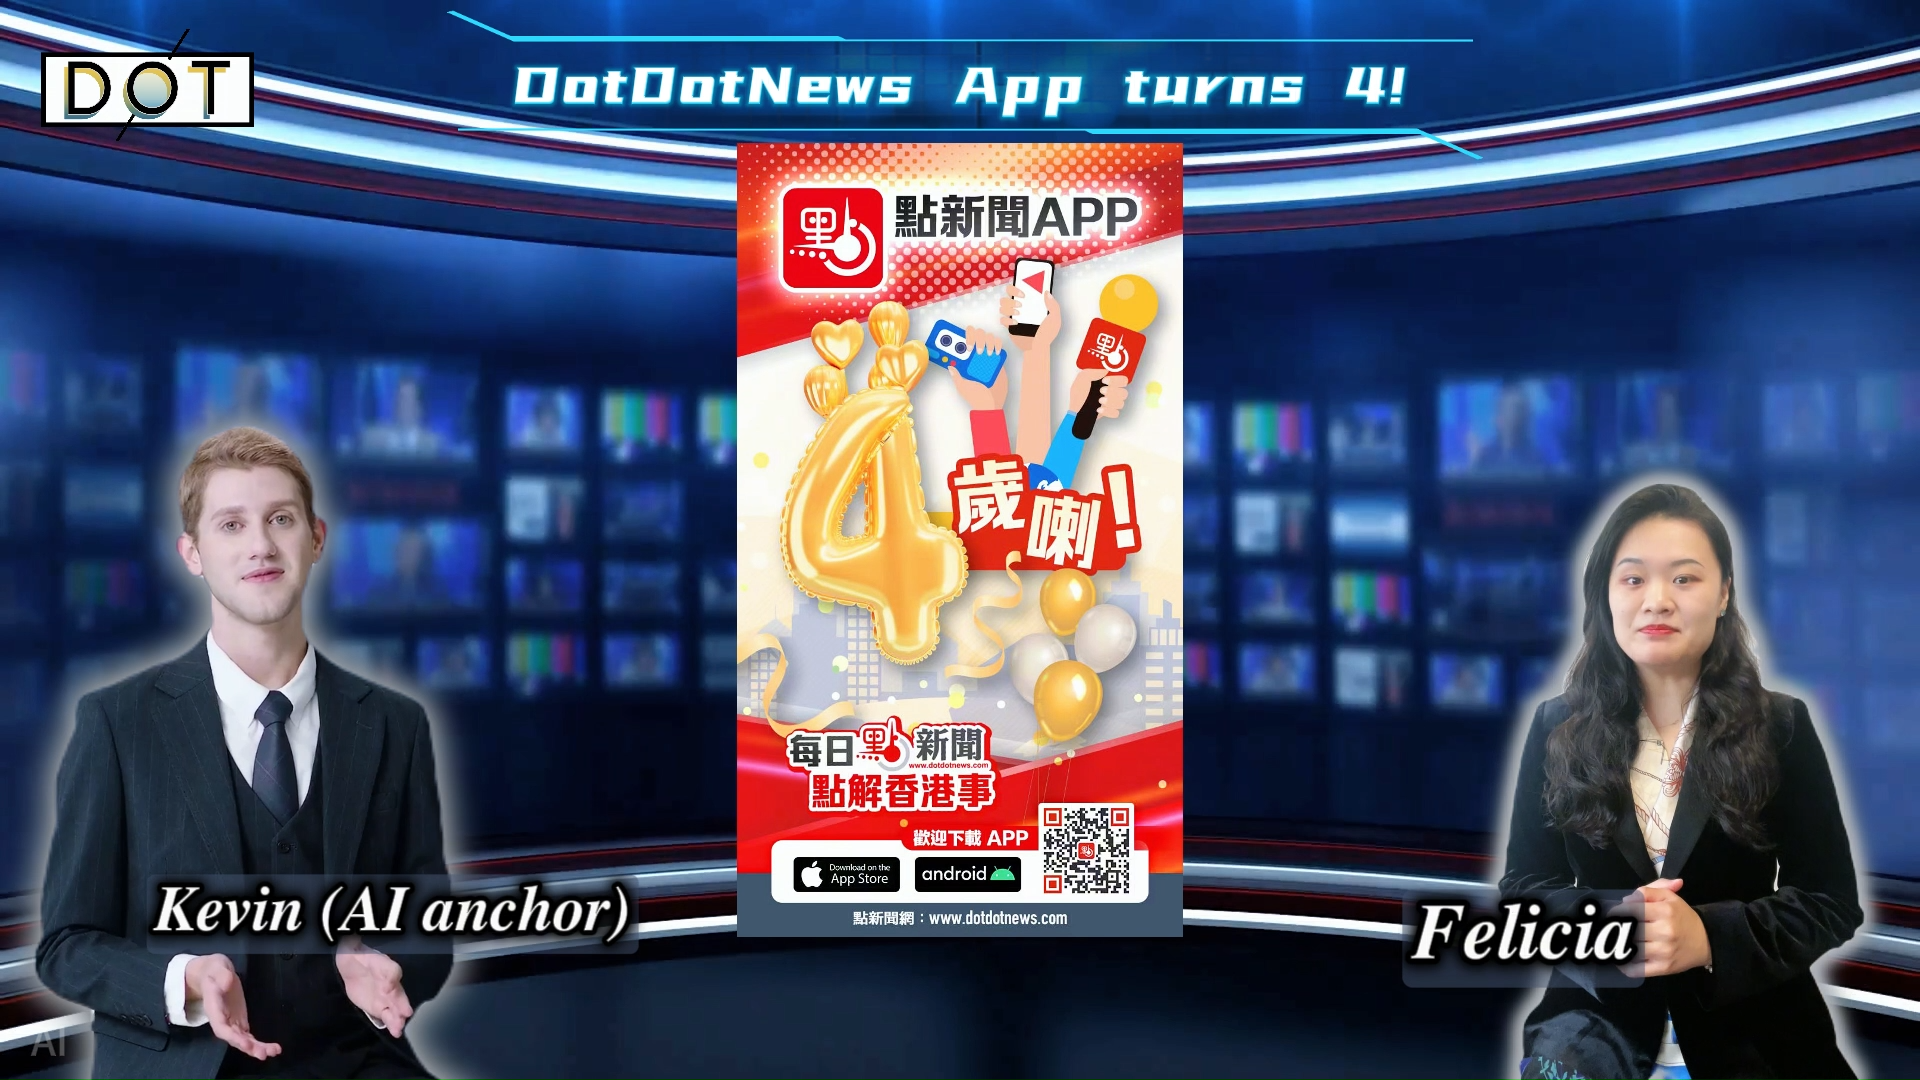
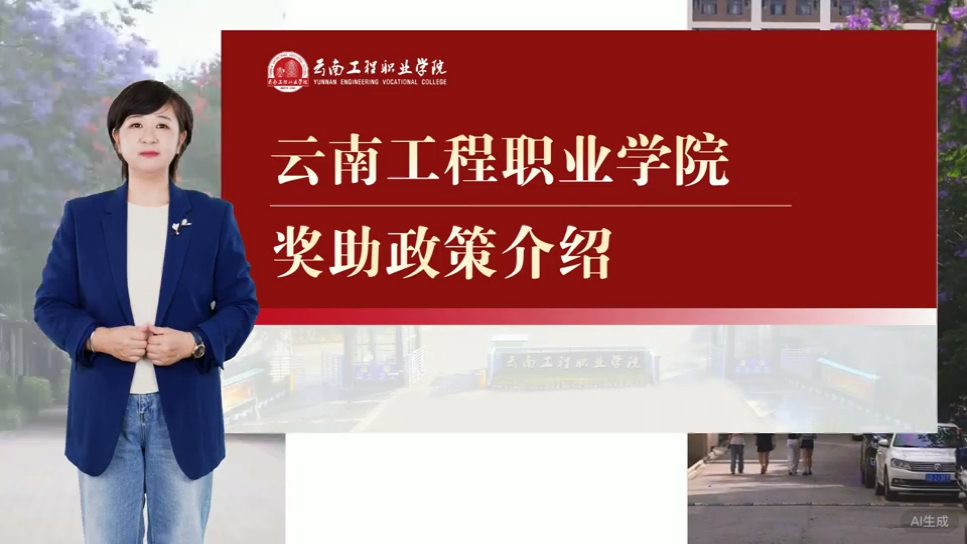
数字人分身克隆是依托多模态 AI 技术,对真人形象、声纹、表达特征进行数字化重建,打造可独立驱动的虚拟分身,核心分为形象复刻、声纹克隆、多模态协同驱动三大环节。
形象复刻基于计算机视觉与三维重建算法,仅需一段真人视频素材,AI 自动提取面部特征点、皮肤纹理、五官形态,构建高保真数字模型。通过深度学习学习真人微表情与神态习惯,还原眨眼、嘴角变化等细节,摆脱传统 CG 建模繁琐流程,快速完成 1:1 外貌复刻。
声纹克隆依托端到端语音神经网络,采集少量真人语音样本,提取独有的声纹、语速、语调与情感韵律,生成高度相似的合成语音。不仅复刻音色,还可根据文本语义自动调整情绪,让声音表达更贴近真人说话习惯。
多模态协同驱动是实现 “形神兼备” 的关键。结合讯飞星火大模型与高精度唇形同步算法,输入文字后,系统同步生成语音、匹配口型、表情与肢体动作,保证音画低延迟同步。实时渲染引擎完成光影与画面输出,让数字分身言行自然连贯。
整套技术无需专业拍摄设备,可快速生成数字分身,广泛应用于直播、智能客服、企业宣讲、微课科普等场景,帮助企业降低出镜成本,实现 7×24 小时稳定内容输出。


用户1
2026/9/19 16:49:27在线声音克隆神器,低门槛搞定专业配音